Фид для Авито я проверяю в два слоя: сначала как технический файл, потом как будущие объявления. XML может быть идеально валидным и при этом загрузить неверную цену, странную категорию, пустую характеристику или одну плохую фотографию на тысячу позиций.
Поэтому моя цель не "добиться зеленого валидатора", а сделать воспроизводимый конвейер: источник данных -> нормализация -> фид -> проверка -> отчет -> модерация -> опубликованное объявление. Ошибка должна быть видна на том этапе, где возникла.
Фид не начинается с XML
Перед кодом я описываю поля бизнеса: внутренний ID, категория, название, описание, цена, характеристики, наличие, адрес/география, контакты и изображения. Затем сопоставляю их с актуальным шаблоном Авито.
Если в исходной CRM размер хранится как "L/XL/52 примерно", разработчик не должен на ходу угадывать значение для классификатора. Сначала данные приводятся к нормальной структуре.
ID - первое поле, которое я защищаю от случайных изменений
Идентификатор должен быть уникальным и стабильным. Я не строю его из названия товара или цены: они меняются. Лучше использовать внутренний ID каталога, который остается тем же на протяжении жизни позиции.
Практики автозагрузки отдельно предупреждают: изменение ID может превратить обновление в новое размещение. Для большого каталога это уже не косметическая ошибка, а риск дублей и потери связи с историей публикации.
Лучше: ID = внутренний SKU 184527. Цена, текст и фото могут обновляться независимо.
Категория и параметры берутся из актуального шаблона
Я не держу универсальный список "обязательных полей Авито", потому что он отличается между категориями и со временем меняется. Беру текущий шаблон и документацию именно для нужной ветки.
Особенно опасны значения классификаторов: визуально похожие варианты могут технически считаться разными. Поэтому маппинг делаю отдельной таблицей и логирую неизвестные значения, а не подставляю первое подходящее.
Price проверяю на реальных строках, а не только по типу данных
Поле может быть числом и при этом быть неправильным. Самая опасная ошибка - перепутать закупочную цену, розницу, цену "от" или цену за единицу измерения.
Перед запуском выбираю 20 случайных товаров и руками сравниваю фид с исходной системой. Для услуг проверяю, что указанная цена соответствует реальному сценарию объявления, а не технической заглушке.
Если цена формируется формулой, добавляю защиту от аномалий: ноль, отрицательное значение, рост в 10 раз и выход за разумный диапазон должны остановить экспорт или попасть в отчет.
Description не должен собирать мусор из базы
Автоматический текст часто выдает внутренние поля склада, HTML-мусор, повтор заголовка десять раз или список ключей. Я собираю описание из смысловых блоков и пропускаю пустые значения.
Если у товара нет характеристики, фраза "Материал: не указано" не помогает. Если у услуги нет гарантии, нельзя автоматически подставлять "гарантия 12 месяцев" из другого шаблона.
Перед массовым запуском читаю минимум 20-30 сгенерированных описаний из разных сегментов. Автоматический тест не поймет, что текст формально правильный, но нелепый.
Фото тестирую отдельным конвейером
Для каждой ссылки проверяю HTTP-доступ, формат, стабильность URL и отсутствие авторизации. Дальше проверяю бизнес-качество: первое фото действительно главное, нет ли заглушки, водяного знака сторонней площадки, контактов или случайной картинки.
У большого каталога ввожу правило: позиция без минимально приемлемого набора фото либо не уходит, либо попадает в отдельный список на доработку. Лучше недогрузить 50 товаров, чем выпустить 50 пустых объявлений, которые испортят статистику.
XML-экранирование и кодировка - мелочь до первой аварии
Амперсанд в названии, кавычки, спецсимволы, переносы и неожиданный HTML способны сломать XML, если генератор собран неаккуратно. Поэтому я не конкатенирую XML строками вручную, а использую нормальную библиотеку/сериализатор.
Файл должен формироваться в требуемой кодировке, а текст проходить безопасное экранирование. CDATA тоже не является волшебной кнопкой: формат должен соответствовать текущей документации.
Валидация и бизнес-проверка - два разных этапа
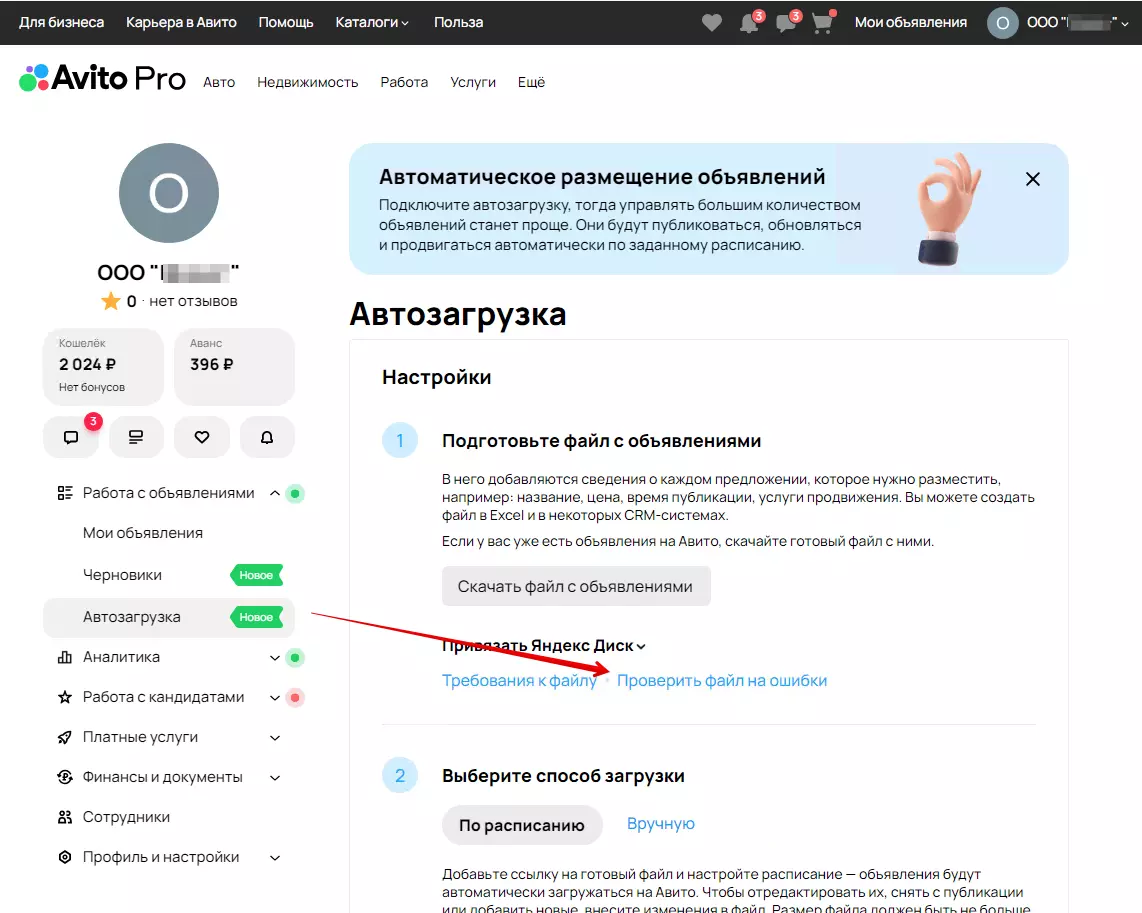
Первый этап отвечает на вопрос "файл соответствует формату?". Второй - "данные соответствуют бизнесу и будущему объявлению?". Я держу оба.
| Техническая проверка | Бизнес-проверка |
|---|---|
| XML корректно сформирован | Цена верная |
| Обязательное поле существует | В поле правильное значение |
| URL фото доступен | Фото относится к этому товару и первое выбрано правильно |
| ID уникален | ID стабилен между выгрузками |
| Категория допустима | Категория соответствует реальному предложению |
Diff перед выгрузкой спасает от массовых ошибок
Для крупного каталога я сравниваю новую версию с предыдущей: сколько позиций добавилось, исчезло, поменяло цену, категорию или фото. Если вчера обновилось 3% товаров, а сегодня система показывает изменение цены у 92%, выгрузку останавливаю.
Это простой, но очень сильный контроль. Он ловит ошибку еще до Авито - например, программист поменял валюту, колонку или правило округления.
Отчет ошибок группирую по причине
Вместо списка из 4 000 красных строк строю сводку: код/текст ошибки -> количество -> пример ID -> ответственное поле. Так становится видно, что 3 600 позиций сломала одна категория, а 12 - отдельные фото.
После исправления перезапускаю только понятный набор, а не меняю пять правил одновременно. Историю отчетов сохраняю, чтобы видеть повторяющиеся дефекты данных.
Практик Семен Демидов в 2026 отдельно обращает внимание на "эффект колонки": одна неверная логика размножается на весь файл. Для меня это ключевой аргумент в пользу сводной диагностики, а не ручной правки строк.
У фида должен быть rollback
Если новая версия генератора испортила объявления, команда должна знать, как вернуть предыдущую рабочую версию данных и остановить расписание. Я храню номер версии генератора, дату файла и архив нескольких последних выгрузок.
Для критичных изменений - новый маппинг категорий, перерасчет цены, другой источник фото - сначала создаю тест на небольшой выборке. Это медленнее на час и быстрее на несколько дней восстановления.
После запуска мониторю не только ошибки файла
Технически чистый фид может ухудшить рекламу. Поэтому после релиза сравниваю показы, просмотры, контакты и долю отклоненных публикаций. Если после изменения шаблона CTR резко упал, проверяю первое фото и заголовок, даже если отчет автозагрузки зеленый.
Также контролирую количество активных публикаций. Внезапное падение или рост на тысячи строк - повод остановиться и проверить источник.
FAQ
Какие поля обязательны в фиде Авито?
Точный набор зависит от категории и текущего шаблона. Нельзя корректно назвать один универсальный список для всех объявлений. Я всегда сверяюсь с документацией конкретной категории.
Что лучше для фида - XML или таблица?
Для автоматической интеграции чаще удобен структурированный машинный формат, но выбор зависит от доступного сценария и источника данных. Главное - стабильность процесса, а не расширение файла.
Можно ли менять ID?
Без причины я этого не делаю. ID должен стабильно идентифицировать одну позицию между обновлениями.
Почему файл проходит проверку, а объявления отклоняются?
Форматная проверка и модерация решают разные задачи. Файл может быть технически корректным, но конкретное объявление нарушать правила категории или содержать проблему в тексте/фото.
Как тестировать изменения фида?
Сначала diff, затем маленькая выборка разных типов позиций, проверка отчета и ручная проверка опубликованных объявлений. Только потом весь каталог.
Вывод
Надежный фид - это не один XML-файл, а контролируемый процесс. В нем есть стабильные ID, нормализованные данные, актуальный шаблон, техническая проверка, бизнес-валидация, тестовая группа, отчет и возможность отката.
Когда этот контур настроен, автозагрузка действительно экономит время. Без него она просто позволяет очень быстро сделать одну и ту же ошибку тысячи раз.
Хотите применить это к своему проекту?
Расскажите о нише и задаче. Я изучу вводные и предложу, с чего начать продвижение на Авито.
Обсудить проект